Google Antigravityで数日〜数週間にわたる長期開発を続けていると、「最初に決めた命名規則をAIが忘れる」「新機能を追加したら昨日動いていた機能が壊れる(先祖返り・デグレ)」と悩むことがあります。
原因は長大化したチャットの自動要約による記憶薄まりです。今回は正本引き継ぎ書『HANDOVER.md』による新セッション10秒移行と自動回帰テスト(ATDD)で手戻りをゼロにする設計を解説します。
わたしもPythonの業務データ集計・検証ツールを何日もかけて開発していたとき、1つのチャットが20往復を超えたあたりから『さっき直したはずのCSV出力仕様が元に戻る』『画面の確認を人間に丸投げしてくる』という現象が連発して頭を抱えました。でも『HANDOVER.md』と『自動回帰テスト』の2つを導入してからは、いつ新しいチャットに切り替えても10秒で記憶が100%引き継がれ、デグレがゼロになりました!
この記事でできるようになること|長期開発の「指示忘れ・先祖返り・デグレ」を根絶する3つのゴール
まずは、なぜ長期開発でAIの「指示忘れ」や「先祖返り」が起きるのか、それを防ぐ全体ロードマップと3つの重要用語を整理します。
そもそも「コンテキスト劣化」「Clean Handover」「回帰テスト」とは?3つの重要用語を30秒で整理
具体的な構築手順に入る前に、本記事で登場する3つの基本用語が「一言でいうと何なのか」を平易な言葉で確認しておきます。
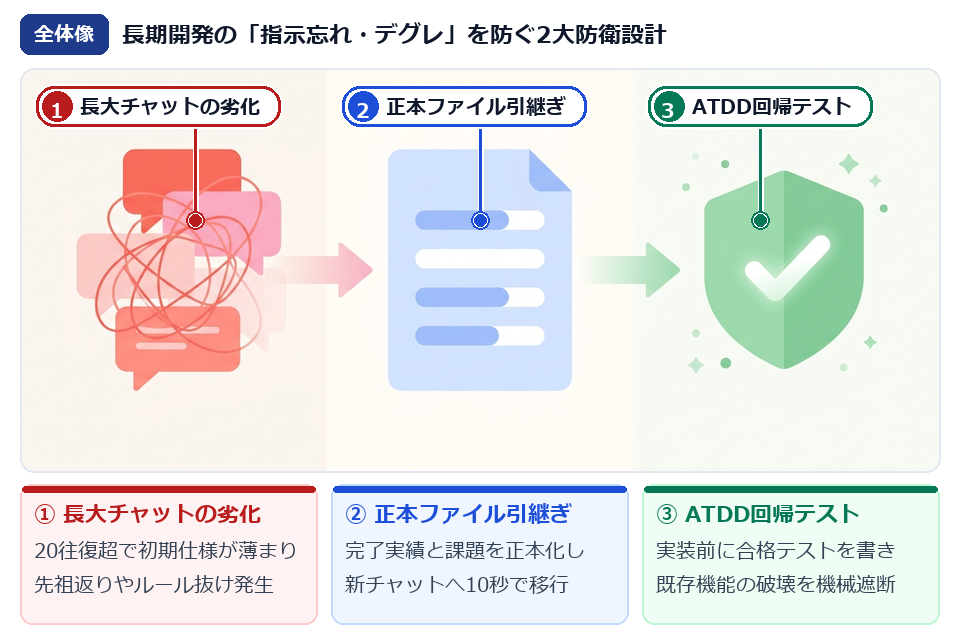
コンテキスト劣化とは、1つのチャット画面で何十往復もやり取りを続けた結果、過去の試行錯誤ログや大量のファイル読み込み履歴でAIの記憶領域が埋まり、「最初に決めた重要なルールや数ターン前の修正内容が要約・圧縮されて抜け落ちてしまう現象」のことです。
この状態のまま開発を続けると、直したはずのバグが再び混入する「先祖返り」が急増します。
HANDOVER.mdとは、1つの機能(サブフェーズ)が完成した区切りで、完了実績・現在の環境状態・次回やるべきタスクをプロジェクト内に書き出して保存する「新しいチャットへ10秒で記憶を引き継ぐための正本引き継ぎファイル(引き継ぎノート)」のことです。
過去の失敗ログというノイズを捨てて確定した仕様だけを新セッションへバトンタッチ(Clean Handover)できるため、AIの推論精度と速度が常に初期の最高状態で維持されます。
ATDDとは、プログラムを書き始める前に「どう動けば合格か」を判定する自動テストを先に作る開発手法のことです。そして回帰テストとは、新しい機能を追加した際に「これまで正常に動いていた既存の機能が1つも壊れていないか(デグレ=退行していないか)」を自動テストプログラムで一括検査する仕組みのことです。
ATDDと回帰テストをセットにすることで、人間が毎回全画面を手動で触って確認する負担をゼロにできます。
専門用語に見えますが、要するに『長話をしてAIが忘れる前に引き継ぎノート(HANDOVER.md)へ書いて新しいチャットへ移ること』と『直した後に他が壊れていないか自動で全部チェックさせること』の2つだけです!この仕組みを一度作っておくと、開発が長引くほどラクになりますよ。
なぜチャットが長くなるとAIは「指示忘れ・先祖返り」を起こすのか?
「昨日までは完璧にルールを守ってくれていたのに、今日続きを指示したら急に古い書き方に戻ってしまった」という現象には、LLM(大規模言語モデル)特有の2つの構造的な理由があります。
- 理由①:長文コンテキストの「中間喪失(Lost in the Middle)」と自動要約による細部仕様の欠落
会話が数十ターンに及びコンテキスト要約(<CONTEXT_SUMMARY>)が発生すると、序盤〜中盤で合意した「特定の例外処理」「カラム幅や文字コードの細かな制約」が抽象的な要約文に圧縮。スタンフォード大学等の研究(Lost in the Middle)でも実証されている通り、長い入力の中間にある情報ほどAIの注意機構(Attention)が薄まり、初期仕様の先祖返りが発生 - 理由②:「完了実績・現在地・次期タスク」をファイルではなくチャット履歴(揮発メモリ)に依存している
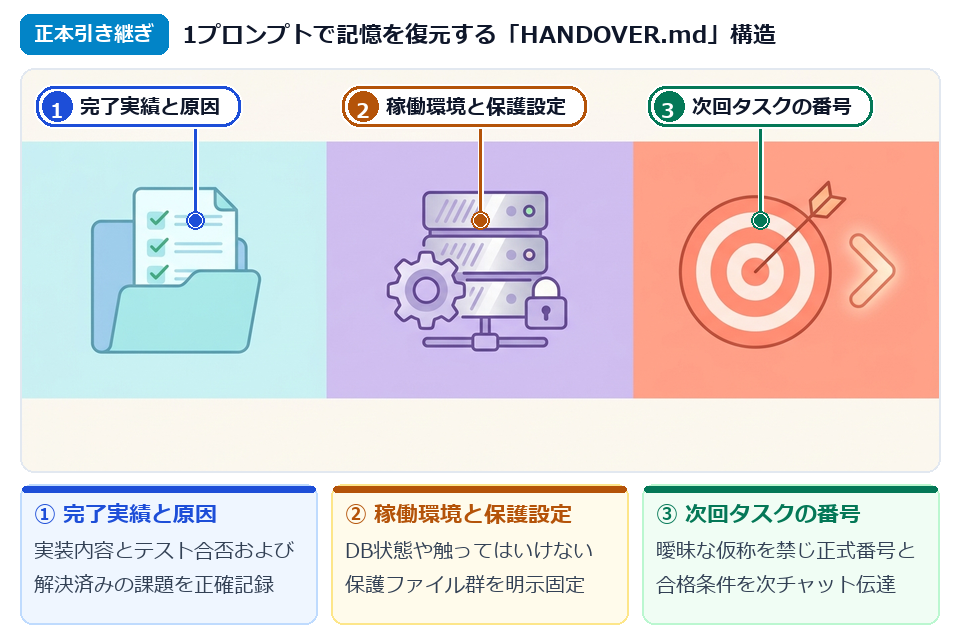
正本ファイルを持たないまま新しいチャットを開くと、AIは「どのファイルが最新の完成版で、どのテーブルがテスト完了しているか」を把握できず、手探りで古いコードを参照して不整合を誘発。プロジェクト直下にHANDOVER.md(正本引き継ぎ書) を配置し、「①直近の完了実績、②現在のシステム稼働状態、③次回着手タスク(正式Phase番号)、④不変ルール」の4章を毎セッション末尾に更新する設計で完全解決
大規模言語モデルが長大なコンテキストを扱う際の精度低下については、Stanford大学等の研究チームによる論文『Lost in the Middle: How Language Models Use Long Contexts』でも定量的に報告されています。
📖 学術研究の要点(Stanford University他『Lost in the Middle』論文より要旨整理)
言語モデルは入力コンテキストの「先頭」または「末尾」に配置された情報に対しては高い検索・遵守精度を示す一方、長大なコンテキストの「中間」に埋もれた情報に対しては認識精度が著しく低下します。重要な仕様や現在の状態は長大な会話ログの中に放置せず、構造化されたドキュメントとして新セッションの先頭で明示的に読み込ませる設計が有効です。
出典:arXiv:2307.03172 - Lost in the Middle: How Language Models Use Long Contexts
『AIなんだから過去のチャットを全部覚えているはず』と思い込んで、1つのチャットで何十回もやり取りを続けていたのが失敗の元でした!大事な決定事項ほどチャットの真ん中に埋もれて忘れられてしまうので、区切りごとに『HANDOVER.md』へ書き出して新しいチャットで先頭から読み込ませるのが一番確実なんですね。
1プロンプトで100%復元する『HANDOVER.md』と5段階ATDD(受け入れテスト駆動開発)の構築手順
ここからは、実際にPython業務データ集計・システム検証バッチの開発で導入し、セッション間の引き継ぎ漏れとデグレをゼロにした具体的な構築手順を2つのステップで解説します。
STEP 1:3パターンのセッション引き継ぎ比較表と『HANDOVER.md』4章構造の設計
長期開発におけるセッション管理の方法を3つのパターンで実測比較しました。なお、「1回きりの使い捨てスクリプトや、15分以内で終わる単発のバグ修正しか行わない場合」は、引き継ぎ書を作らずそのまま1つのチャットで完結させて問題ありません。
以前は新しいチャットを開くたびに『前回こういうテーブルを作って、こういう注意点があって…』と10分以上かけて説明文を書いていたのですが、それでも伝え漏れが出てしまっていました。この比較表の通り、AI自身にセッション終了時の『HANDOVER.md』更新まで任せてしまうのが一番ミスがなくて圧倒的に速いです!
AIコーディング環境での長期開発において、仕様の先祖返りやデグレを防ぎ、人間と生成AIが共通の設計書・自動テストを軸に開発を進める実践ノウハウが体系的にまとまった一冊です。
自律型AIエージェントが会話履歴(コンテキスト)をどのように要約・保持し、なぜ長期セッションで指示忘れが起きるのかという基礎構造から、正本ドキュメントによる引き継ぎ設計まで詳しく学べます。
STEP 2:コードを1行も書く前に合格条件を定義する「5段階ATDD」と「SHA-256差分回帰テスト」
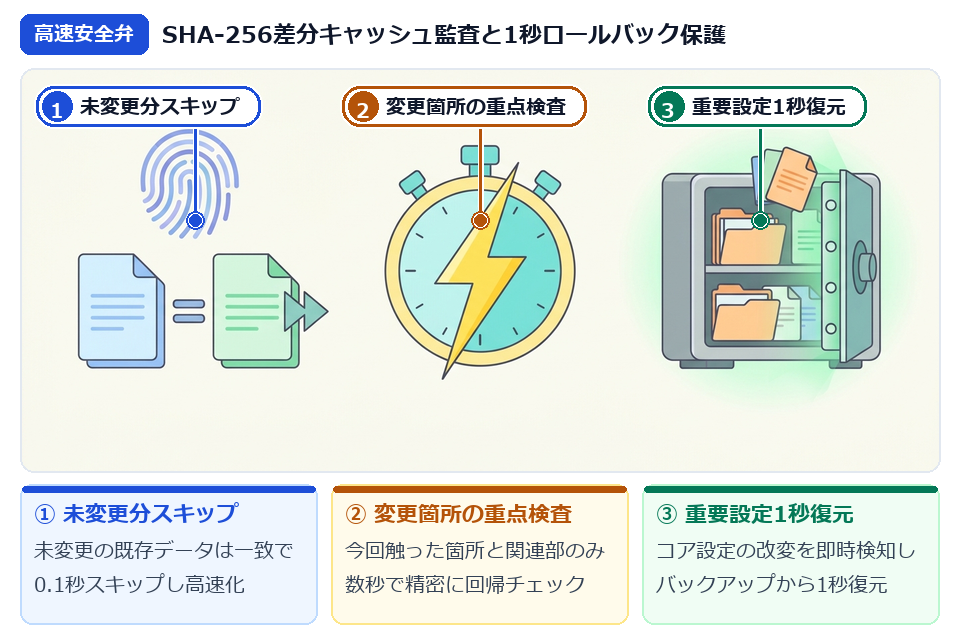
HANDOVER.md で記憶を引き継ぐのと同時に、AIが勝手に既存仕様を書き換えてしまう事故を物理的に防ぐ仕組みが「5段階ATDD(受け入れテスト駆動開発)」と「SHA-256ハッシュによる高速回帰テスト&スナップショット保護」です。
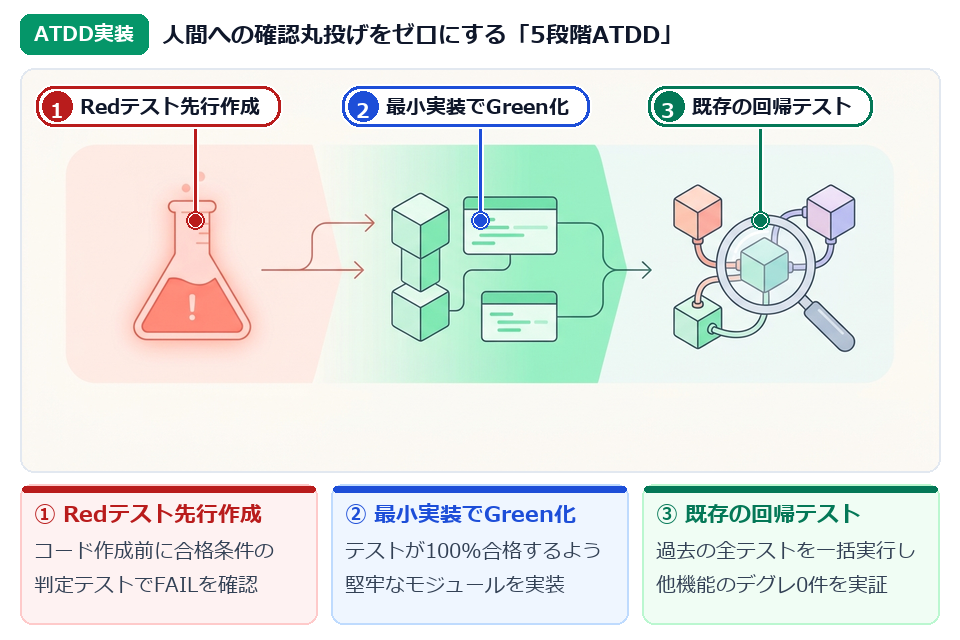
- 【手順①:実装前のATDD受入テスト先行作成(Red ➔ Green)】
機能追加やバグ修正に入る際、コードを書き始める前に「①合格条件(Acceptance Criteria)の箇条書き宣言」と「②それを機械判定するPythonテストスクリプトの作成(未実装でのFAIL=Red確認)」を義務化。そのテストが100% PASS(Green)になるまでAI自身が自己修正を完結 - 【手順②:SHA-256差分キャッシュによる高速回帰テスト】
既存のモジュールや出力データが増えても回帰テストが重くならないよう、各データと検証ルールファイルのSHA-256ハッシュ値を記録。未変更の資産はキャッシュ判定で0.1秒スキップし、今回変更した箇所と関連モジュールだけを重点検査する高速差分監査を構築 - 【手順③:重要設定ファイルのスナップショット検証と1秒ロールバック安全弁】
絶対に壊したくないコア設定ファイルや共通バリデータ群のSHA-256ハッシュ一覧をbackups/に保存。ビルド前後にverify_snapshot()で1バイトの意図しない改変もないことを自動検証し、万一書き換えられた場合も1コマンド・1秒未満で完全復元
お手元のプロジェクト直下に作成してそのまま使える HANDOVER.md(4章構造テンプレート)と次回開始用プロンプト です。
## 1. 直近セッションの完了実績と解決した課題
・Phase X-1(〇〇集計モジュールの実装&自動テスト4件 PASS)完了。
・原因と対策:〇〇の入力欠損時に例外が出る課題を特定し、デフォルト値補完と単体テスト(
tests/test_phase_x1.py)へ恒久統合済。## 2. 現在のシステム稼働状態・インフラ情報
・実行環境:Python 3.12(
.venv) / SQLite DB(data/app.db)・コア設定スナップショット:
verify_snapshot() 100%一致(改変0件)・回帰テストスイート:
tests/test_phase_x1.py ALL PASS## 3. 次回着手タスク: 【Phase X-2】〇〇レポート出力機能の実装
・合格条件 (AC-1):既存モジュールを無傷維持したまま、〇〇形式のレポートを出力できること。
・合格条件 (AC-2):実装前に
tests/test_phase_x2.py を作成し、Red ➔ Green を確認すること。## 4. 新規チャット担当エージェントへの絶対遵守規約
・曖昧な「案A / 案B」表記を禁止し、必ずロードマップの正式通し番号(Phase X-Y)で記述すること。
・人間に手動動作確認を丸投げせず、ATDD自動テストと回帰テストのPASSログを添えて完了報告すること。
・サブフェーズ完了時は本ファイルを最新化し、新チャット移行(Clean Handover)用の開始プロンプトを提示すること。
以前公開した「Google Antigravityで「Deadline exceeded: Agent execution terminated due to error.」が出た時の根本解決!単一ステップ巨大ファイル出力の罠とモジュール分割・非同期化の実測対策」や「Google Antigravityを最速・高品質にする『GEMINI.md』作業前ルール設計術!手戻りゼロと週次クォータ65%節約を両立する4階層モデル分業ガイド」と今回の『HANDOVER.md+ATDD回帰テスト』を組み合わせると、Google Antigravityでの開発が本当に別次元になります!新しいチャットを開いて『HANDOVER.mdを読み込んでPhase X-2を開始してください』と1行貼るだけで、前回の続きから寸分の狂いもなく開発が進む快感をぜひ味わってみてください!
AIエージェントに曖昧さのない合格条件(ATDD)と回帰テストコードを書かせ、長期プロジェクトでも破綻しないシステム設計力を実践形式で身につけられるエンジニア育成講座です。

本体を動かさずに親指だけでカーソルを精密に操作できる人間工学設計のトラックボールマウスです。Antigravityのエディタ画面とテスト実行ターミナルを長時間行き来しても手首が疲れません。
まとめ|今夜まず試してほしい「プロジェクトルートへの『HANDOVER.md』4章テンプレート作成」
Google Antigravityでの長期開発において、会話の肥大化による「指示忘れ・先祖返り・デグレ」を根本から防ぐ『HANDOVER.md』正本引き継ぎと自動回帰テスト(ATDD)の設計手順を振り返りました。
- 長大チャットの罠(コンテキスト劣化)を防ぐ
1つのチャットで何十往復も続けると自動要約で細部仕様が薄まるため、1サブフェーズ完了ごとに正本ファイルへ記録して新チャットへ移行(Clean Handover)する運用 - 正本引き継ぎ書『HANDOVER.md』の4章構造で固定する
「①完了実績、②現在の稼働状態、③次回着手タスク(正式Phase番号)、④絶対遵守規約」を固定フォーマットで管理し、1行のプロンプトで100%記憶復元 - 5段階ATDDとSHA-256回帰テストでデグレを封じる
実装前に合格条件とテストコード(Red)を書き、スナップショット検証(verify_snapshot)と差分回帰テストで既存機能のデグレを物理的にゼロ化
まずは今夜、現在進めているプロジェクトのフォルダ直下に『HANDOVER.md』を1つ作り、今動いているチャットに『現在の完了実績・システム状態・次にやるタスクをHANDOVER.mdに書き出してください』と指示するところから一歩ずつ試してみてください。明日からの開発が驚くほどスムーズで安心なものになりますよ!
あわせて、Antigravityで「Deadline exceeded」エラーが出たときの450行モジュール分割対策や、週次クォータを65%節約する『GEMINI.md』4階層モデル分業ガイドもぜひご覧ください。
単一ステップ巨大ファイル出力によるDeadline exceeded強制終了を450行モジュール分割で解決する実測手順です。
作業前カスタムルール『GEMINI.md』と親AI・子AI・Pythonの4階層分業でクォータを65%節約する実践ガイドです。